Scan2OCR
Опция фонового распознавания текста для сканеров Scan2Net: книги, дела и другие документы сразу сохраняются в многостраничные PDF с поиском по тексту.
Разработчик: Image Access GmbH, Германия
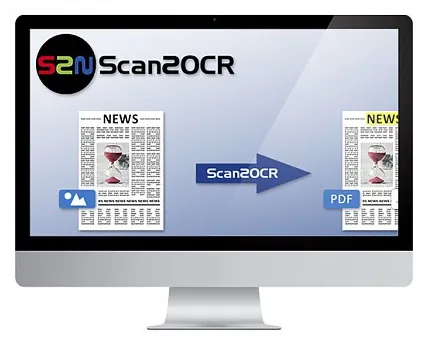
Scan2OCR — программная опция, которая превращает книги, дела и другие документы в многостраничные PDF-файлы с возможностью поиска по тексту. Распознавание выполняется в самом сканере в фоновом режиме, поэтому оператор продолжает сканировать, не дожидаясь результатов OCR; чтобы не замедлять сканирование, распознавание идёт с низким приоритетом.
Опция использует систему распознавания Tesseract и программу анализа макета страницы Leptonica и поддерживает более 100 языков, включая многие азиатские. Английский и немецкий установлены на сканере по умолчанию, остальные языковые пакеты бесплатно загружаются с портала Image Access. Для одного шаблона можно выбрать не более двух языков распознавания; производитель рекомендует разрешение не ниже 300 dpi. Scan2OCR работает в режиме заданий (Job Mode) ScanWizard с выводом в PDF, а также совместно с Batch Scan Wizard.
Возможности
- Многостраничные PDF с поиском по тексту
- Распознавание в фоне во время сканирования — без ожидания результатов OCR
- OCR выполняется в самом сканере с низким приоритетом, чтобы не замедлять сканирование
- Система распознавания Tesseract и анализ макета страницы Leptonica
- Более 100 языков, включая многие азиатские; английский и немецкий предустановлены
- Дополнительные языковые пакеты — бесплатно с портала Image Access
- До двух языков распознавания на шаблон; рекомендуемое разрешение — не ниже 300 dpi
Документация
Документы производителя (PDF) открываются на сайте производителя.
Инструкции и спецификации
Источники: imageaccess.de/…/s2n-software-options · cdn.imageaccess.de/…/FAQ-OCR.pdf · cdn.imageaccess.de/…/Product_Catalog_EN.pdf · cdn.imageaccess.de/…/WideTEK_Flatbed_PL_E_Internet.pdf · cdn.imageaccess.de/…/Prospekt_WT24F-600_EN.pdf